
Für Healthtech-Unternehmen kann ein einziger fehlender Nachweis einen Deal platzen lassen. Krankenhaussysteme, Krankenkassen und Enterprise-Partner verlangen SOC 2, bevor sie überhaupt eine Sicherheitsprüfung des Anbieters beginnen – kein Bericht, kein Vertrag. In genau dieser Lage befand sich ein Healthtech-Unternehmen in der Wachstumsphase: starkes Produkt, echte Kundennachfrage, aber eine Compliance-Lücke, die zwischen ihm und der nächsten großen Partnerschaft stand.
Die Herausforderung
Das Unternehmen hatte bereits ein funktionierendes Produkt auf AWS und einen wachsenden Kundenstamm aufgebaut, doch die Software war von Anfang an nicht auf Compliance ausgelegt. Logging, Zugriffskontrollen, Verschlüsselungspraktiken und Lieferantenmanagement hatten sich allesamt organisch entwickelt, um schnell Features auszuliefern, nicht um einen Auditor zufriedenzustellen. Das Unternehmen war bereit, Enterprise-Kunden zu gewinnen, doch SOC 2 tauchte immer wieder als Hindernis auf, bevor entsprechende Gespräche überhaupt beginnen konnten. Ohne einen Bericht in der Hand gerieten Sicherheitsprüfungen ins Stocken, noch bevor sie begonnen hatten.
Damit standen wir vor einem bekannten Problem: Compliance nachträglich in ein System einzubauen, das nie dafür konzipiert war, und das unter echtem Termindruck, ohne den Rest der Roadmap auszubremsen.
Unser Vorgehen
Wir haben mit einer Readiness-Analyse begonnen, um zu sehen, wie groß die Lücke zwischen den bestehenden Praktiken und den Kontrollanforderungen von SOC 2 tatsächlich war.
Neben einer Reihe kleinerer Feststellungen brachte die Readiness-Analyse sieben wesentliche Lücken zutage, die sofortige Aufmerksamkeit erforderten.
- Logischer Zugriff (CC6.1, Logische Zugriffskontrollen): Alle Umgebungen (Dev, Staging und Produktion) liefen im selben AWS-Konto, ohne Trennung zwischen ihnen.
- IAM-Hygiene (CC6.2 und CC6.3, Bereitstellung von Benutzerzugriffen und Least Privilege): Im Laufe der Zeit hatten sich ungenutzte Benutzer und Rollen angesammelt, und Berechtigungsgrenzen waren nicht klar definiert.
- Verschlüsselung und Backups (CC6.1 und A1.2, Verschlüsselung und Verfügbarkeit/Wiederherstellung): Daten waren im Ruhezustand verschlüsselt, aber die Wiederherstellung aus Backups war nie tatsächlich getestet worden.
- Infrastructure as Code (CC8.1, Change Management): IaC wasn’t fully automated, and the deployed infrastructure had drifted from what the IaC actually described.
- Nachvollziehbarkeit von Deployments (CC8.1, Change Management): Es war nicht immer klar, welche Anwendungsversion in einer bestimmten Umgebung lief, was auf Lücken im Design der CI/CD-Pipeline hindeutete.
- Logging und Monitoring (CC7.1 und CC7.2, Systembetrieb): CloudTrail, AWS Config und Security Hub waren nicht vollständig in der gesamten Umgebung konfiguriert.
- Nachweiserhebung (CC4.1, Überwachungsaktivitäten): Es gab keinen einheitlichen Prozess zum Sammeln und Pflegen der Nachweise, die ein Auditor benötigt, um Kontrollen über einen längeren Zeitraum hinweg zu überprüfen.
Die Lösungen
Sobald wir das vollständige Bild hatten, haben wir in den folgenden Monaten jede Lücke systematisch abgearbeitet.
Logischer Zugriff
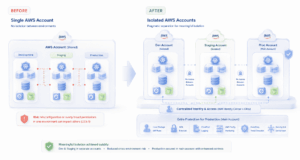
Alle drei Umgebungen – Dev, Staging und Produktion – liefen ursprünglich in einem einzigen AWS-Konto, ohne echte Trennung zwischen ihnen. Das bedeutete, dass sich eine Fehlkonfiguration oder eine zu weit gefasste Berechtigung in einer Umgebung auf eine andere auswirken konnte – genau die Art von Risiko, die CC6.1 erkennen soll.
Eine vollständige Trennung war der ideale Endzustand, aber die Migration der Produktion aus dem Hauptkonto war kein einfaches Unterfangen. In der Produktion liefen der Live-EKS-Cluster, die RDS-Instanzen und alles, was davon abhing, und eine vollständige Kontomigration für dieses Ökosystem hätte ein echtes Risiko mit sich gebracht und Monate gekostet, die wir angesichts des Zeitplans für den Deal nicht hatten. Deshalb haben wir eine pragmatische Entscheidung getroffen: Wir haben Dev und Staging in eigene, separate Konten verschoben, was den Großteil des Risikos einer gegenseitigen Beeinträchtigung zwischen den unteren Umgebungen und der Produktion beseitigte, und die Produktion für diese Phase im Hauptkonto belassen, ergänzt durch strengere Zugriffskontrollen und ein engmaschigeres Monitoring als Ausgleich.
So erreichten wir schnell eine spürbare Isolation, ohne unter Termindruck eine risikoreiche Migration der Produktion in Angriff nehmen zu müssen.
IAM hygiene
Der Zugriff wurde zuvor über einzelne IAM-Benutzer verwaltet, was bedeutete: Zugangsdaten, die rotiert werden mussten, keine zentrale Stelle, an der sich einsehen ließ, wer worauf Zugriff hatte, und Berechtigungsgrenzen, die sich im Laufe der Zeit verschoben hatten, weil Personen ins Unternehmen kamen, es verließen oder ihre Rollen wechselten. Das ist eine direkte Lücke gegenüber CC6.2 und CC6.3, da es keine saubere Möglichkeit gab, nachzuweisen, dass Zugriffe konsistent bereitgestellt, überprüft oder entzogen wurden.
Wir haben die Benutzerverwaltung in IAM Identity Center verlagert und es mit Okta integriert, das der Kunde bereits nutzte, sodass Identitäten an einem Ort verwaltet wurden, statt über AWS hinweg dupliziert zu werden. Die Bereitstellung und Entfernung von Benutzern wurde über SCIM zwischen Okta und Identity Center automatisiert, sodass der Zugriff dem tatsächlichen Beschäftigungsstatus einer Person folgte, anstatt darauf angewiesen zu sein, dass jemand daran dachte, einen IAM-Benutzer nach dem Ausscheiden der Person zu bereinigen.
Für den nicht-menschlichen Zugriff, etwa die zuvor für CI/CD genutzten IAM-Benutzer, haben wir Deployments auf OIDC-basierte Rollenübernahme aus GitHub Actions umgestellt, beschränkt auf die minimalen Berechtigungen, die jede Pipeline tatsächlich benötigte, anstelle von weit gefassten, langlebigen Zugangsdaten.
All das – die Identity-Center-Konfiguration, die SCIM-Integration und die OIDC-Rollen – wurde über Terraform definiert und verwaltet, sodass das Zugriffsmodell selbst prüfbar und versioniert wurde, statt manuell in der Konsole konfiguriert zu werden.
Verschlüsselung and backup
Daten waren bereits im Ruhezustand verschlüsselt, was einen Teil von CC6.1 abdeckte, aber die Wiederherstellung aus Backups war nie tatsächlich getestet worden, und es gab kein Multi-Region-Resilienzkonzept, auf das man verweisen konnte. Ein Auditor will nicht nur sehen, dass Backups existieren; er will Nachweise dafür, dass die Wiederherstellung tatsächlich funktioniert und dass Daten den Ausfall einer ganzen Region überstehen.
Wir haben Multi-Region-Backups für RDS und DynamoDB aktiviert, sodass sowohl die primären relationalen Daten als auch die NoSQL-Workloads einen dokumentierten Wiederherstellungspfad außerhalb einer einzelnen AWS-Region hatten. Zusätzlich haben wir einen regelmäßigen, zeitgesteuerten Test der Backup-Wiederherstellung eingerichtet, sodass die Wiederherstellung wiederholt nachgewiesen wurde, anstatt davon auszugehen, dass sie funktioniert, nur weil ein Backup-Job erfolgreich gelaufen war.
Infrastruktur als Code
Für die Produktion haben wir die vorhandenen Ressourcen in den Terraform-State importiert, anstatt alles von Grund auf neu zu erstellen und Ausfallzeiten oder Konfigurationsabweichungen zu riskieren. Dadurch kam die Produktion unter IaC-Verwaltung, ohne die Live-Umgebung anzutasten, und die Drift-Lücke wurde geschlossen, ohne ein Migrationsrisiko einzugehen.
Dev und Staging haben wir mit denselben Terraform-Modulen aufgebaut wie die Produktion, parametrisiert über Umgebungsvariablen, um die Ressourcen für die unteren Umgebungen angemessen zu verkleinern. Dadurch hatten wir eine konsistente, replizierte Infrastruktur in allen drei Umgebungen aus einer einzigen Codebasis, statt separater, von Hand gepflegter Konfigurationen, die im Laufe der Zeit unbemerkt auseinanderdriften konnten.
Wir haben IaC-Deployments so automatisiert, dass sie über Pipelines mit Freigaben ausgeführt werden.
Deployment-Rückverfolgbarkeit
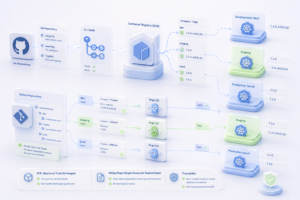
Wir haben ArgoCD eingeführt und GitOps-Praktiken in der gesamten Pipeline übernommen, sodass der Soll-Zustand jeder Umgebung in Git lag, statt manuell oder uneinheitlich angewendet zu werden. Jedes Image wurde beim Build in GitHub je nach Umgebung mit einer SemVer-Struktur getaggt. So entstand eine klare, unveränderliche Verknüpfung zwischen einem bestimmten Commit, seinem Build-Artefakt und dem, was zu jedem Zeitpunkt tatsächlich in einer Umgebung lief.
Dadurch erhielten wir außerdem ein echtes Rollback: Die Rückkehr zu einem früheren Zustand ließ sich nun dadurch erreichen, ArgoCD auf einen früheren Git-Commit zurückzusetzen, statt ein vergangenes Deployment manuell zu rekonstruieren. Zusammengenommen schloss dies die Nachvollziehbarkeitslücke und gab dem Auditor eine klare, überprüfbare Spur vom Code bis in die Produktion.
Protokollierung und Überwachung
CloudTrail, AWS Config und Security Hub waren nicht in allen Umgebungen vollständig konfiguriert, was eine eingeschränkte Transparenz über Kontoaktivitäten, Konfigurationsänderungen und potenzielle Bedrohungen bedeutete – eine direkte Lücke gemäß CC7.1 und CC7.2 für die Systemüberwachung.
Wir haben CloudTrail in allen Konten für eine lückenlose Aktivitätsprotokollierung aktiviert, AWS Config eingeschaltet, um Konfigurationsabweichungen zu erfassen und zu melden, und GuardDuty für die kontinuierliche Bedrohungserkennung bereitgestellt. All das floss in Security Hub ein, sodass wir eine einzige, zentrale Sicht auf Feststellungen und Warnmeldungen in der gesamten Umgebung hatten, statt jeden Service einzeln zu prüfen
Beweiserhebung
Wir haben Vanta eingesetzt, um die Erfassung von Nachweisen über AWS, GitHub und Okta hinweg kontinuierlich zu automatisieren, sodass Kontrollnachweise in dem Moment festgehalten wurden, in dem sie entstanden, statt im Nachhinein rekonstruiert zu werden. Dadurch hatten wir während des gesamten Beobachtungszeitraums einen Echtzeit-Überblick über den Compliance-Status und gingen mit bereits geordneten Nachweisen in das Audit, statt sie unter Termindruck zusammenzustellen.
Ergebnisse und Vorteile
Wir haben die sieben wesentlichen Lücken geschlossen und die zugrunde liegende Infrastruktur in den ersten zwei bis drei Monaten neu aufgebaut. Danach trat das Unternehmen in einen sechsmonatigen Beobachtungszeitraum ein, in dem Monitoring, Incident Response, Zugriffsüberprüfungen und Nachweiserhebung kontinuierlich liefen und als Nachweis dafür dokumentiert wurden, dass die Kontrollen über längere Zeit wirksam funktionierten und nicht nur auf dem Papier existierten.
Am Ende dieses Zeitfensters bestand das Unternehmen sein SOC-2-Type-II-Audit, etwa neun Monate nach Beginn der Readiness-Analyse. Was zuvor ein Hindernis zwischen dem Unternehmen und Enterprise-Deals gewesen war, wurde zu einem Nachweis, der Sicherheitsprüfungen voranbrachte, statt sie ins Stocken geraten zu lassen, noch bevor sie begonnen hatten.